What Do VLAs Actually Learn through In-Context Failure Conditioning?
Jiajun Liu, Jieming Li, Zi Zhuang, Hang Yu, Qingli Chen,
Liu Cao,
Yingxi Lu,
Ruoqu Chen,
Yuhang Cao,
Chenyu Zhang,
Yankai Lin, and
Mengdi Xu† In CVPR 2026 Workshop on 3D-LLM/VLA, 2026
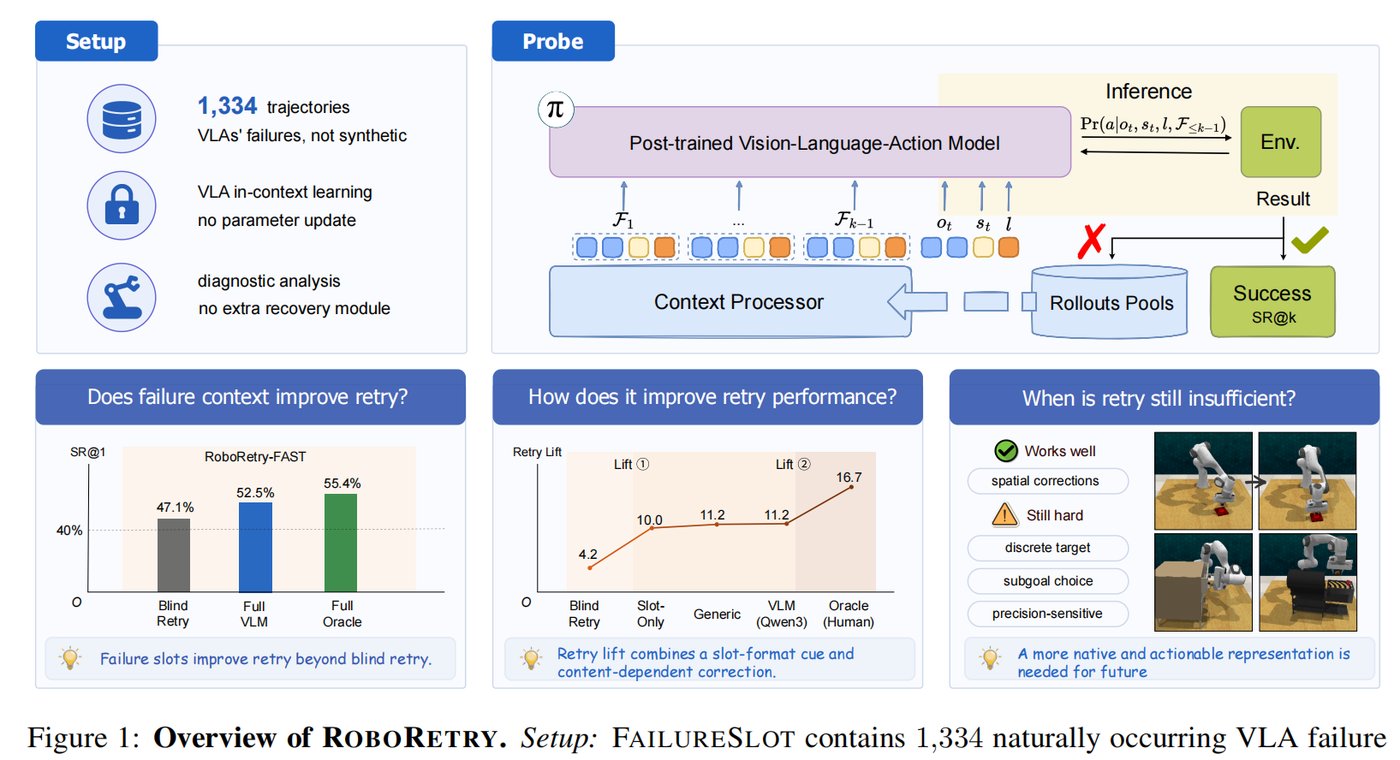
Using RoboRetry as a controlled probe across 12 RLBench tasks, we study whether vision-language-action policies actually learn from prior failures via in-context conditioning, disentangling a slot-presence effect from content-dependent gains, and release FailureSlot, a dataset of 1,334 annotated failure trajectories.